hackeps 2025: com vam quedar segons al repte d'eurecat
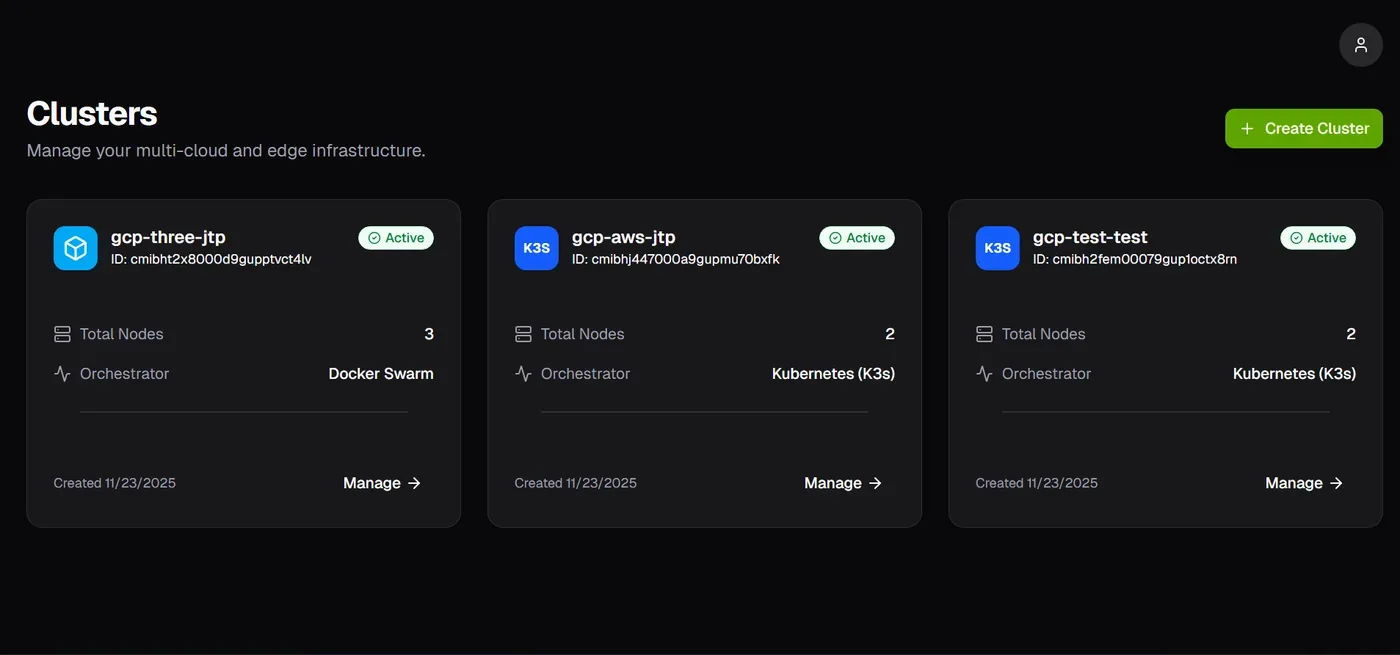
el 22 i el 23 de novembre de 2025 vaig fer la hackeps amb la maria aliet. és la hackató de l'escola politècnica superior de la universitat de lleida: novena edició, més de 230 inscrits i 24 hores. vam triar el repte d'eurecat, que demanava una plataforma per desplegar i gestionar clústers de computació híbrids, amb màquines a aws i a google cloud i dispositius edge, tot des del mateix lloc.
vam quedar segons. però a la meitat de la hackató no teníem res que funcionés, i vam esborrar-ho tot per tornar a començar.
el pla amb go, connect i protocol buffers
vam començar com si tinguéssim un mes. backend en go, amb connect-go i protocol buffers, per tenir els tipus compartits de punta a punta entre el servidor i el client.
sobre el paper té sentit. a la pràctica, cada endpoint nou vol una definició al fitxer .proto, generar el codi de go i el del client i implementar el handler, abans que cap botó faci res. a l'equador del concurs teníem un diagrama d'arquitectura preciós i zero funcionalitats acabades.
vam fer un hard reset i ho vam passar tot a t3:
- next.js i trpc, per tenir tipus compartits entre client i servidor sense generar codi.
- postgresql amb prisma, per poder canviar l'esquema sense maldecaps.
- tailwind i shadcn, per tenir una interfície decent en minuts.
del go no en queda res al repositori, que comença directament amb la versió nova. el que vam presentar són 3.832 línies de typescript nostres en 60 fitxers, 1.494 d'elles al servidor, més 5.745 de components de shadcn que no vam escriure.
el retall també es veu a l'esquema de la base de dades. el primer tenia quatre orquestradors possibles: k3s, nomad, docker swarm i kubernetes. una migració posterior en va treure nomad i kubernetes, que no hi hauria temps de fer.
com es crea un clúster a aws i google cloud
primer guardes les credencials de cada proveïdor: la clau d'accés i el secret d'aws, o el json d'un compte de servei de google cloud. després crees un clúster. hi tries docker swarm o k3s, hi afegeixes nodes amb un proveïdor i un tipus d'instància i en marques un com a màster.
en crear-lo, una mutació de trpc desa el clúster i els nodes en estat pending dins d'una transacció, i crida provisionCluster, que fa la feina en tres etapes.
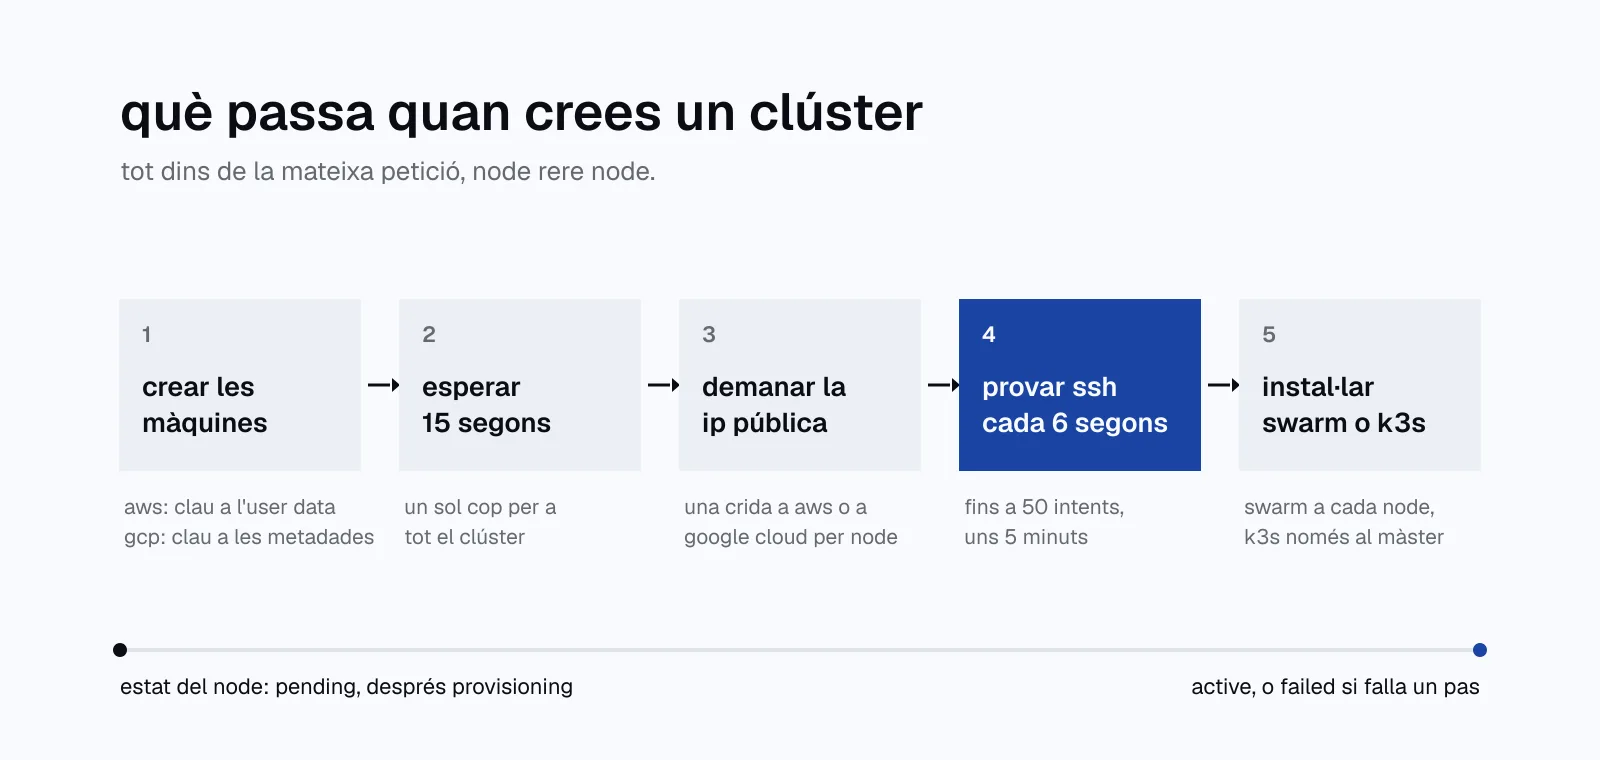
primer llança les màquines. el servidor genera un parell de claus rsa de 4.096 bits per clúster. a aws, la clau pública entra per l'user data, un script que l'afegeix a authorized_keys quan la màquina arrenca. a google cloud, entra per les metadades ssh-keys de la instància. després espera 15 segons i demana a cada proveïdor la ip pública. finalment s'hi connecta per ssh, instal·la l'orquestrador i marca el node com a actiu.
demanar la ip pública a google cloud va ser de les últimes coses que vam afegir, i fins llavors cap node de google cloud no passava de l'estat provisioning.
node.js genera claus rsa, però no les sap exportar en el format d'openssh que esperen aws i google cloud. així que hi ha una funció escrita a mà que llegeix la clau pem byte a byte, n'extreu el mòdul i l'exponent i munta la clau ssh-rsa tal com la descriu l'rfc 4253.
la clau privada, en canvi, va a parar a la base de dades en text pla, al costat d'un comentari que diu "in a real app, this field should be encrypted :)".
el polling per ssh
no teníem temps per muntar una cua de tasques, així que vam improvisar. un bucle prova de connectar-se per ssh a cada màquina nova i hi executa un echo. si falla, espera sis segons i torna a provar. el node només passa a actiu quan respon. sense els logs, és això:
async function waitForSSH(ip: string, user: string, privateKey: string, maxRetries = 50) {
  for (let i = 0; i < maxRetries; i++) {
    try {
      await executeRemoteCommand(ip, user, privateKey, ["echo 'SSH Ready'"]);
      return;
    } catch (e) {
      await new Promise((r) => setTimeout(r, 6000));
    }
  }
  throw new Error(`SSH Connection timed out after ${maxRetries} attempts`);
}
el límit era de 20 intents, uns dos minuts, i el vam haver de pujar a 50, uns cinc.
tot això passa dins de la mateixa petició http que crea el clúster, que no respon fins que l'últim node ha acabat. perquè no et quedis mirant el formulari, el botó dispara la mutació i et porta al tauler sense esperar la resposta.
un dels commits es diu "parallelisation of provisioning", però el codi continua sent seqüencial. el que va canviar és l'ordre. abans, cada node es creava i esperava 15 segons la seva ip. després, es llancen tots, s'espera 15 segons una sola vegada i es recullen totes les ips. un comentari dins del mateix codi ho admet: "for safety in a hackathon (rate limits), let's keep it sequential but fast".
desplegar una aplicació també passa per ssh, sempre al màster. amb swarm, el servidor hi executa docker service create amb la imatge que li dones. amb k3s, codifica el manifest en base64, el descodifica a la màquina i hi fa kubectl apply. així el yaml arriba sencer, sense haver de lluitar amb les cometes dins d'una ordre de shell.
el que va quedar a mitges
el codi també ensenya el que no va arribar a funcionar:
- a swarm, cada node executa
docker swarm initpel seu compte, i amb k3s només s'instal·la al màster. els nodes no s'uneixen entre ells, perquè cap no fajoin. - els dispositius edge es registren amb una ip i un usuari, i es marquen com a actius si tenen ip, sense connectar-s'hi.
- a aws hi ha una sola ami i un sol security group escrits al codi. l'ami és la de us-west-2 i s'utilitza a qualsevol regió, tot i que cada ami només existeix a la regió on es va crear.
el readme, escrit dos dies després, també llista el que no hi va arribar. la part d'ia del repte, triar proveïdor i regió a partir d'una petició en llenguatge natural, va quedar dissenyada però sense connectar. i la primera millora de la llista és una cua amb redis i bullmq que tregui l'aprovisionament de la petició http. és la peça que el polling per ssh va haver de substituir.