claude code para estudiar: un servidor mcp con todos los exámenes
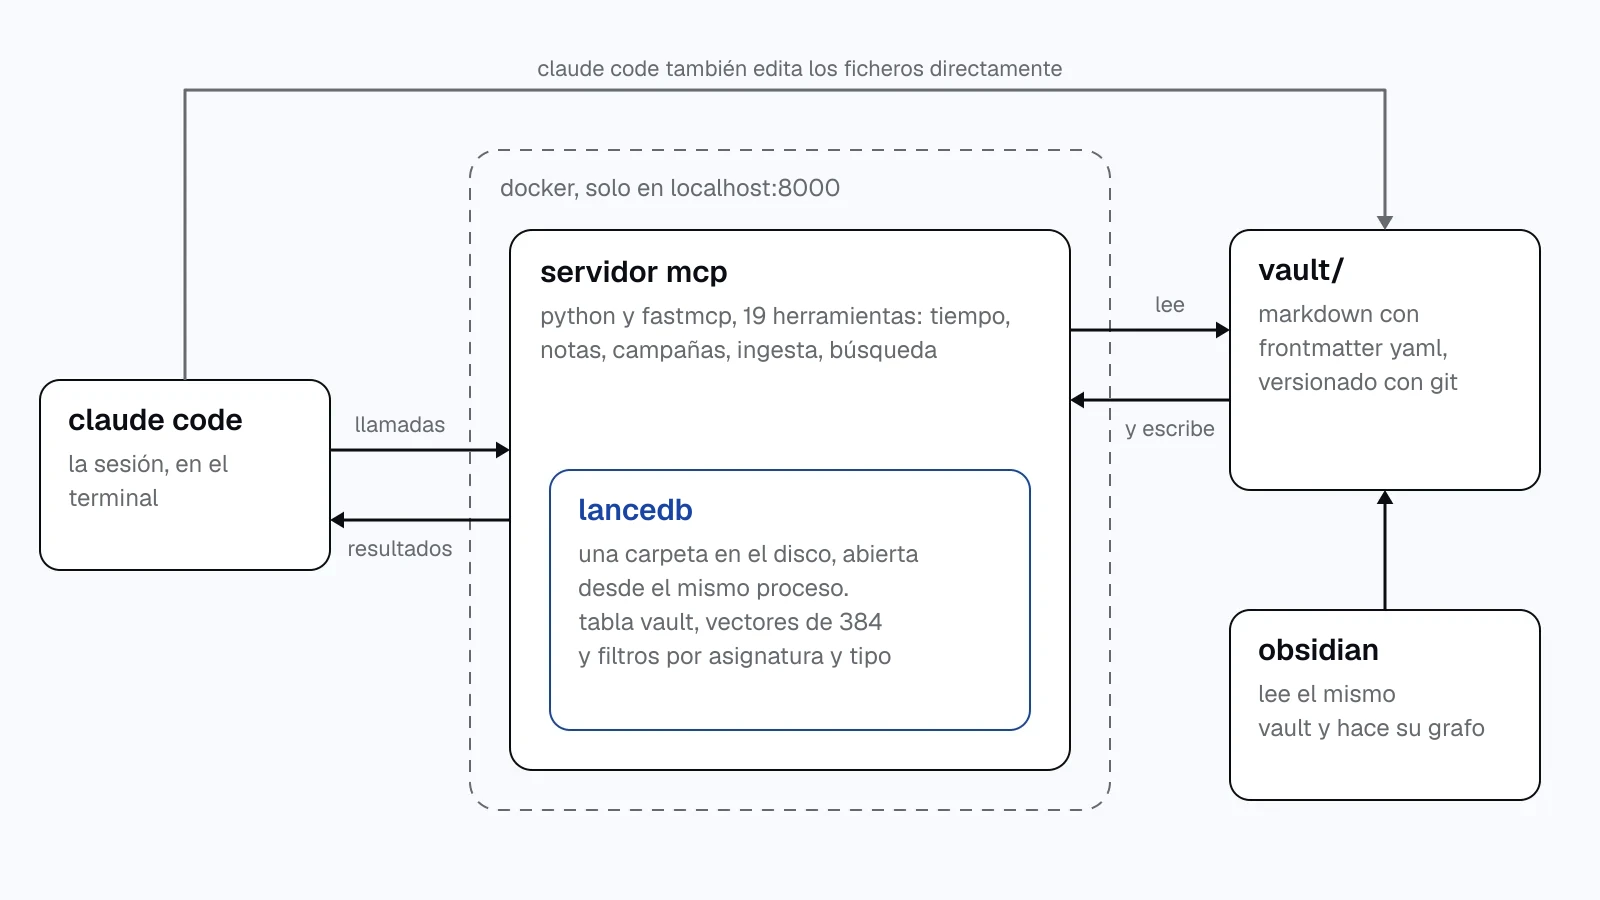
mi profesor particular es claude code. se ha leído todos los exámenes de mi carrera, y se acuerda de más cosas que yo.
estudiar en la uni es sobre todo un problema de gestión de la información. apuntes, exámenes de otros años, prácticas, notas, pistas que dejan caer los profesores en clase, y todo disperso. a dos semanas del examen, la pregunta no es qué estudiar, es qué estudiar primero.
el código es público como plantilla, uni-assistant-template. son 1.846 líneas de python, contando los scripts. el vault con mis apuntes y exámenes es privado.
el servidor mcp y sus 19 herramientas
un modelo lee bien un examen, pero no sabe qué día es, no suma ponderaciones de forma fiable y no recuerda la sesión del martes. para cada una de estas carencias hay una herramienta en un servidor mcp, escrito en python con fastmcp. hay 19:
| grupo | herramientas |
|---|---|
| tiempo | get_current_time, get_session_duration |
| panel | get_dashboard |
| asignaturas y notas | list_subjects, get_subject, compute_marks_status |
| campañas | list_exams, get_campaign, update_campaign |
| registro | log_progress, get_session_log |
| ingesta | process_ingest_folder, ingest_file, rebuild_index |
| búsqueda | search_knowledge |
| pdfs | render_page, export_markdown_to_pdf |
| git | git_sync, git_pull |
el servidor lleva unas instrucciones que claude code recibe al conectarse. la primera dice que, al empezar cada sesión, llame a get_current_time() y después a get_dashboard(), y la documentación de la herramienta insiste en que la hora no se debe deducir nunca de la conversación. el contenedor de docker va en utc por defecto, y el 10 de junio tuve que añadir la zona horaria para que la hora fuera la de casa.
compute_marks_status hace la aritmética. lee los componentes de la nota de cada asignatura, con su peso, su mínimo y si se pueden recuperar, y calcula qué hay que sacar en lo que queda:
needed_total = passing_threshold * total_weight
already_have = current_contribution
needed_on_remaining = (needed_total - already_have) / unscored_weight
si ni con un 10 en todo lo que falta se llega al aprobado, la herramienta dice que es matemáticamente imposible y recomienda dedicar el tiempo a otra cosa. si un componente no recuperable se ha quedado por debajo del mínimo, avisa de que es un suspenso global.
de los exámenes en pdf al vault
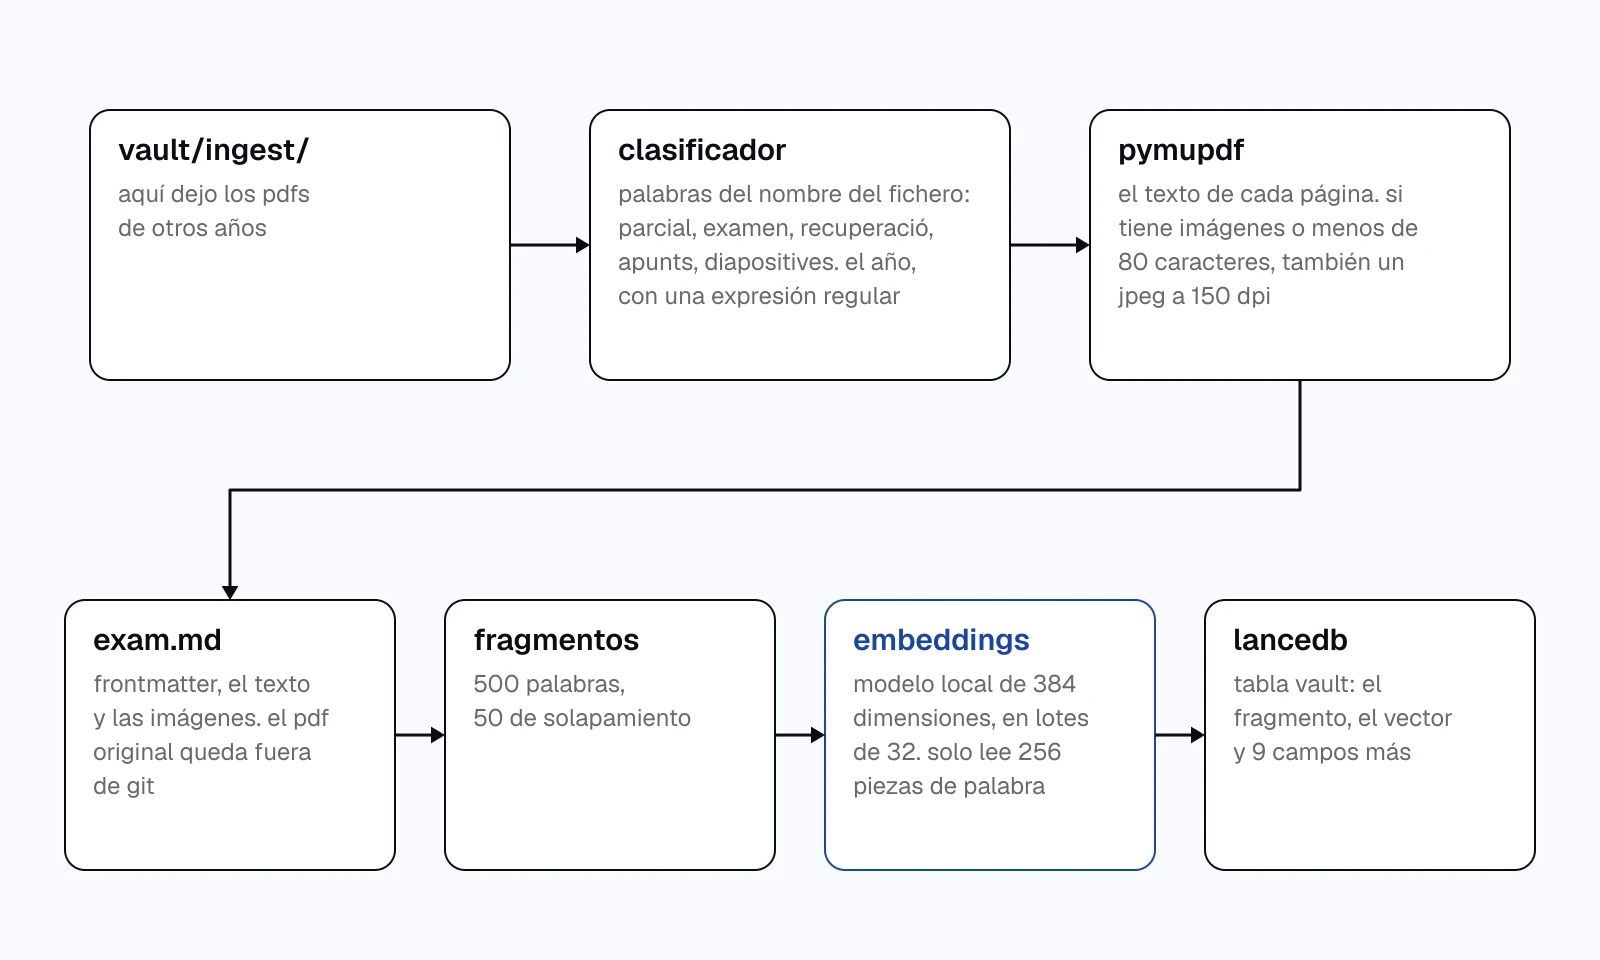
para alimentarlo, dejo los pdfs en vault/ingest/. process_ingest_folder() los lista con una primera clasificación que sale solo del nombre del fichero. busca palabras como parcial, examen, recuperació, apunts o diapositives, en catalán, castellano e inglés, y el año con una expresión regular. si el nombre es claro, la herramienta dice que se puede ingerir. si no, el agente me pregunta qué es antes de llamar a ingest_file().
de un examen, pymupdf saca el texto página a página. si una página tiene imágenes incrustadas o menos de 80 caracteres de texto, también la renderiza en jpeg a 150 dpi. es una regla tosca, pero cubre los dos casos que importan, un diagrama que no sale en el texto y un examen escaneado que no tiene texto. claude lee imágenes, así que esas páginas le llegan como imagen.
el resultado es un exam.md. el frontmatter dice la asignatura, el tipo de examen, el año, cuántas páginas tiene y cuáles son visuales, y debajo va el texto de cada página con sus imágenes al lado. el pdf original se copia a una carpeta raw/ que git ignora.
el primer día entraron 83 pdfs de exámenes de cuatro asignaturas, 13 de ellos escaneados.
la búsqueda semántica con lancedb
la base de datos vectorial es lancedb, que no tiene servidor. lancedb.connect() recibe una carpeta, y la base de datos vive dentro del proceso del servidor mcp. hay una sola tabla, vault, con el texto de cada fragmento, el vector y nueve campos más: el identificador, el fichero de origen, el tipo, la asignatura, el semestre, el tema, la fuente, la calidad y la fecha.
los fragmentos se cortan por palabras:
def _chunk_text(text: str, chunk_size: int = 500, overlap: int = 50) -> list[str]:
    words = text.split()
    chunks = []
    i = 0
    while i < len(words):
        chunk = " ".join(words[i:i + chunk_size])
        chunks.append(chunk)
        i += chunk_size - overlap
    return chunks or [text]
cada fragmento pasa por all-MiniLM-L6-v2, un modelo de sentence-transformers que corre en la misma máquina y devuelve vectores de 384 dimensiones, sin ninguna api de pago.
search_knowledge convierte la pregunta en un vector, busca los cinco fragmentos más cercanos y los filtra por asignatura y por tipo de contenido, que puede ser apuntes, exámenes, normativa o campañas. de cada resultado devuelve 400 caracteres y la ruta del fichero, para que el agente abra el documento entero si le hace falta.
del vps al ordenador en un día
el 8 de junio, el primer día, el servidor vivía en un vps con coolify, con subdominio propio y una clave de api. antes de meterle nada hicieron falta dos correcciones típicas de un servidor mcp remoto. BaseHTTPMiddleware, el middleware de starlette que usaba para la clave, acumula la respuesta entera antes de enviarla y rompía el streaming, así que lo cambié por un middleware asgi puro. y la comprobación de fastmcp contra el dns rebinding rechazaba las peticiones hasta que normalicé la cabecera Host.
a las cinco de la tarde ingerí los 83 exámenes. casi tres horas después lo moví todo a un docker en el ordenador, abierto solo en localhost:8000. el mismo commit calcula los embeddings en lotes de 32 para no quedarse sin memoria, y el plan del proyecto pasa a decir que todo corre en una sola máquina, sin latencia de red ni límites de ram. el acceso desde el móvil por telegram quedó descartado ese mismo día.
lancedb y los embeddings locales ya estaban desde el primer día. en el plan, lancedb está porque no necesita ningún proceso aparte, y el modelo porque es local y gratuito. después del cambio, todo el sistema es un contenedor al lado del vault.
las campañas de estudio
una campaña es un campaign.md por examen, con una cola de exámenes de años anteriores, del más nuevo al más antiguo, y para cada uno los ejercicios hechos y los que quedan. update_campaign mueve un ejercicio de una lista a la otra, y cuando no queda ninguno, da el examen por terminado.
el criterio de prioridad está en el readme. el objetivo por defecto es un 5 en cada asignatura. el plan del proyecto lo justifica diciendo que el tiempo es de suma cero, y una hora en una asignatura que ya apruebas es una hora que no pones en la que puedes suspender. se estudia con exámenes reales desde el primer día, y se hace una pasada superficial por todo antes de profundizar en nada.
get_dashboard ordena las campañas activas por los días que faltan para el examen, añade las entregas de los próximos 14 días y propone empezar por la más urgente. log_progress, que el agente tiene que llamar después de cada respuesta, deja una entrada con la hora, qué se ha hecho, cómo ha ido y los minutos desde la anterior. cuando vuelvo al día siguiente, get_session_log dice dónde lo dejé.
los patrones de los exámenes, qué temas salen cada año y cuáles no han salido nunca, los encuentra claude leyendo los exam.md de la cola con estas herramientas. el código solo aporta una heurística en el panel, que cuenta los títulos que se repiten en tres exámenes o más.
markdown, git y obsidian
todo lo que sabe el sistema es markdown con frontmatter yaml. cada asignatura tiene un INDEX.md con los componentes de la nota, cada campaña su campaign.md y su log.md, cada examen su exam.md. las herramientas del servidor, claude code y obsidian leen los mismos ficheros. obsidian añade el grafo conceptual de toda la carrera, y git, el historial, con git_sync para hacer el commit y el push desde la conversación.
el 9 de junio añadí una regla a las instrucciones del agente. primero el vault, después la memoria. cuando le doy un dato nuevo, una fecha o una decisión, tiene que actualizar el fichero del vault antes que su memoria, porque la memoria es un resumen que sale del vault, y nunca al revés.
el 13 de junio publiqué la plantilla, sin el vault.
lo que cambiaría
hay tres cosas que no aguantan una lectura atenta del código.
la primera es el tamaño de los fragmentos. según la ficha del modelo, todo lo que pasa de 256 piezas de palabra se corta, y cada palabra es como mínimo una pieza. de cada fragmento de 500 palabras, el vector ve como mucho las 256 primeras. como empieza un fragmento nuevo cada 450 palabras, en un documento largo al menos 194 de cada 450 palabras no entran en ningún vector. además, la ficha dice language: en, y el clasificador busca palabras en catalán como apunts o recuperació.
la segunda, que search_knowledge vuelve a cargar el modelo en cada consulta. la función que indexa ya acepta el modelo como parámetro, y la búsqueda no lo aprovecha.
la tercera, que la heurística del panel cuenta títulos, y cada exam.md tiene un título por página: ## Page 1, ## Page 2. con tres exámenes de una asignatura, "page 1" ya sale como tema que se repite.
la primera es la que más importa. en unos apuntes largos, más del 40% del texto no entra en ningún vector, y ninguna búsqueda semántica lo puede encontrar.