claude code per estudiar: un servidor mcp amb tots els exàmens
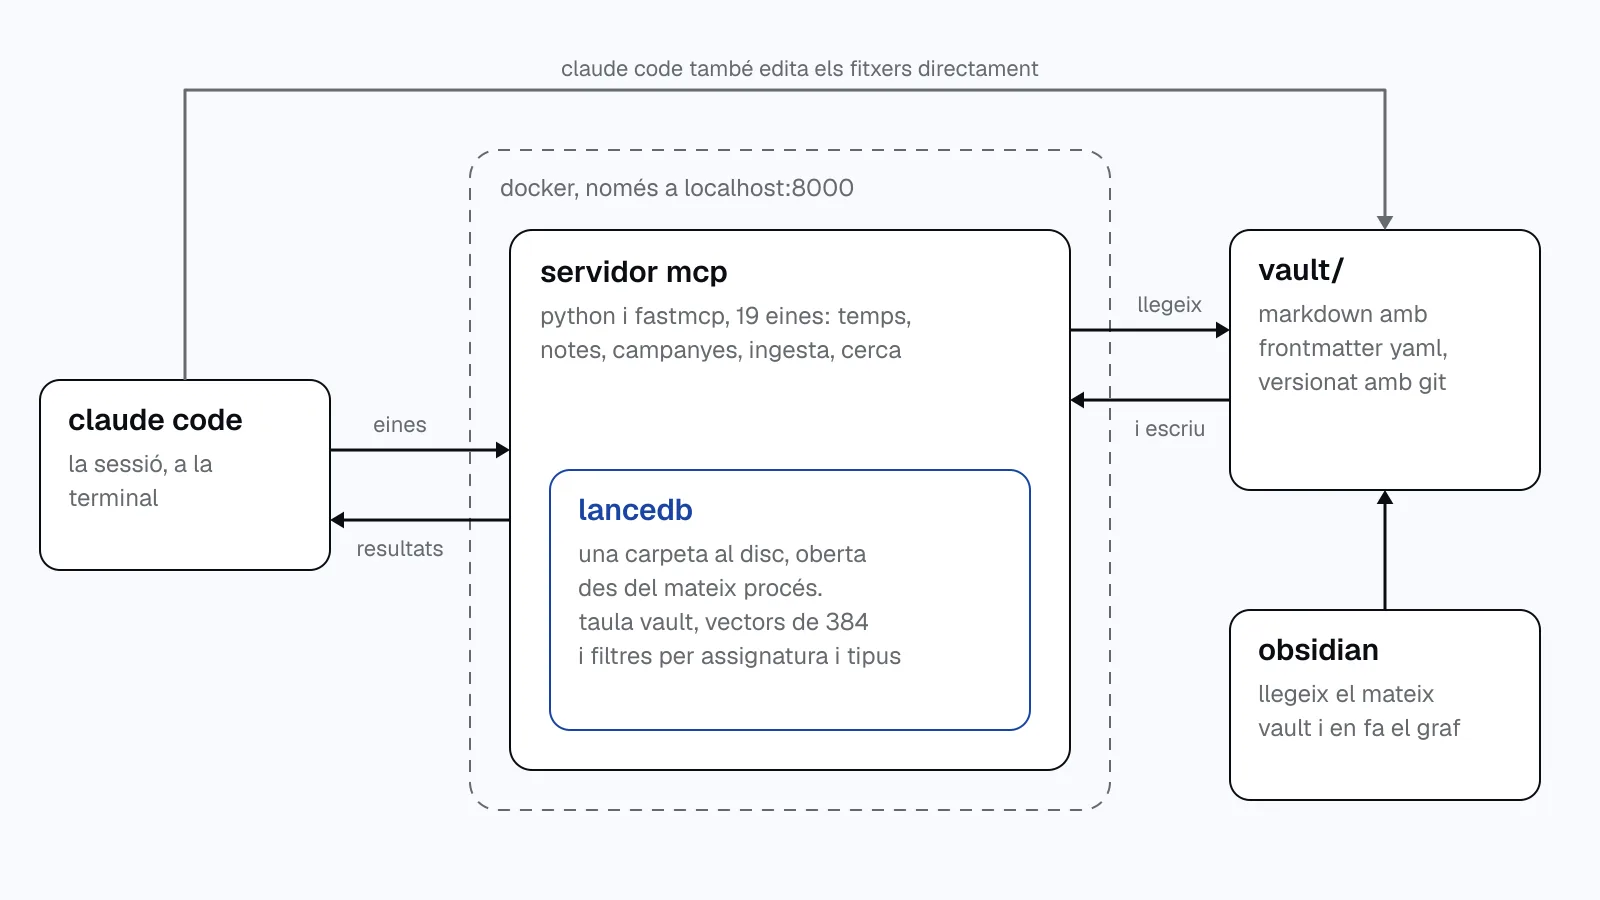
el meu professor particular és claude code. s'ha llegit tots els exàmens de la meva carrera, i recorda més coses que jo.
estudiar a la uni és sobretot un problema de gestió d'informació. apunts, exàmens d'altres anys, pràctiques, notes, pistes que deixen anar els professors a classe, i tot dispers. a dues setmanes de l'examen, la pregunta no és què estudiar, és què estudiar primer.
el codi és públic com a plantilla, uni-assistant-template. són 1.846 línies de python, comptant els scripts. el vault amb els meus apunts i exàmens és privat.
el servidor mcp i les seves 19 eines
un model llegeix bé un examen, però no sap quin dia és, no suma ponderacions amb fiabilitat i no recorda la sessió de dimarts. per a cadascuna d'aquestes mancances hi ha una eina en un servidor mcp, escrit en python amb fastmcp. n'hi ha 19:
| grup | eines |
|---|---|
| temps | get_current_time, get_session_duration |
| tauler | get_dashboard |
| assignatures i notes | list_subjects, get_subject, compute_marks_status |
| campanyes | list_exams, get_campaign, update_campaign |
| registre | log_progress, get_session_log |
| ingesta | process_ingest_folder, ingest_file, rebuild_index |
| cerca | search_knowledge |
| pdfs | render_page, export_markdown_to_pdf |
| git | git_sync, git_pull |
el servidor porta unes instruccions que claude code rep en connectar-s'hi. la primera diu que a l'inici de cada sessió cridi get_current_time() i després get_dashboard(), i la documentació de l'eina insisteix que l'hora no s'ha de deduir mai de la conversa. el contenidor de docker va en utc per defecte, i el 10 de juny vaig haver d'afegir la zona horària perquè l'hora fos la de casa.
compute_marks_status fa l'aritmètica. llegeix els components de la nota de cada assignatura, amb el pes, el mínim i si es poden recuperar, i calcula què cal treure en el que queda:
needed_total = passing_threshold * total_weight
already_have = current_contribution
needed_on_remaining = (needed_total - already_have) / unscored_weight
si ni amb un 10 a tot el que falta s'arriba a l'aprovat, l'eina diu que és matemàticament impossible i recomana dedicar el temps a una altra cosa. si un component no recuperable ha quedat per sota del mínim, avisa que és un suspens global.
dels exàmens en pdf al vault
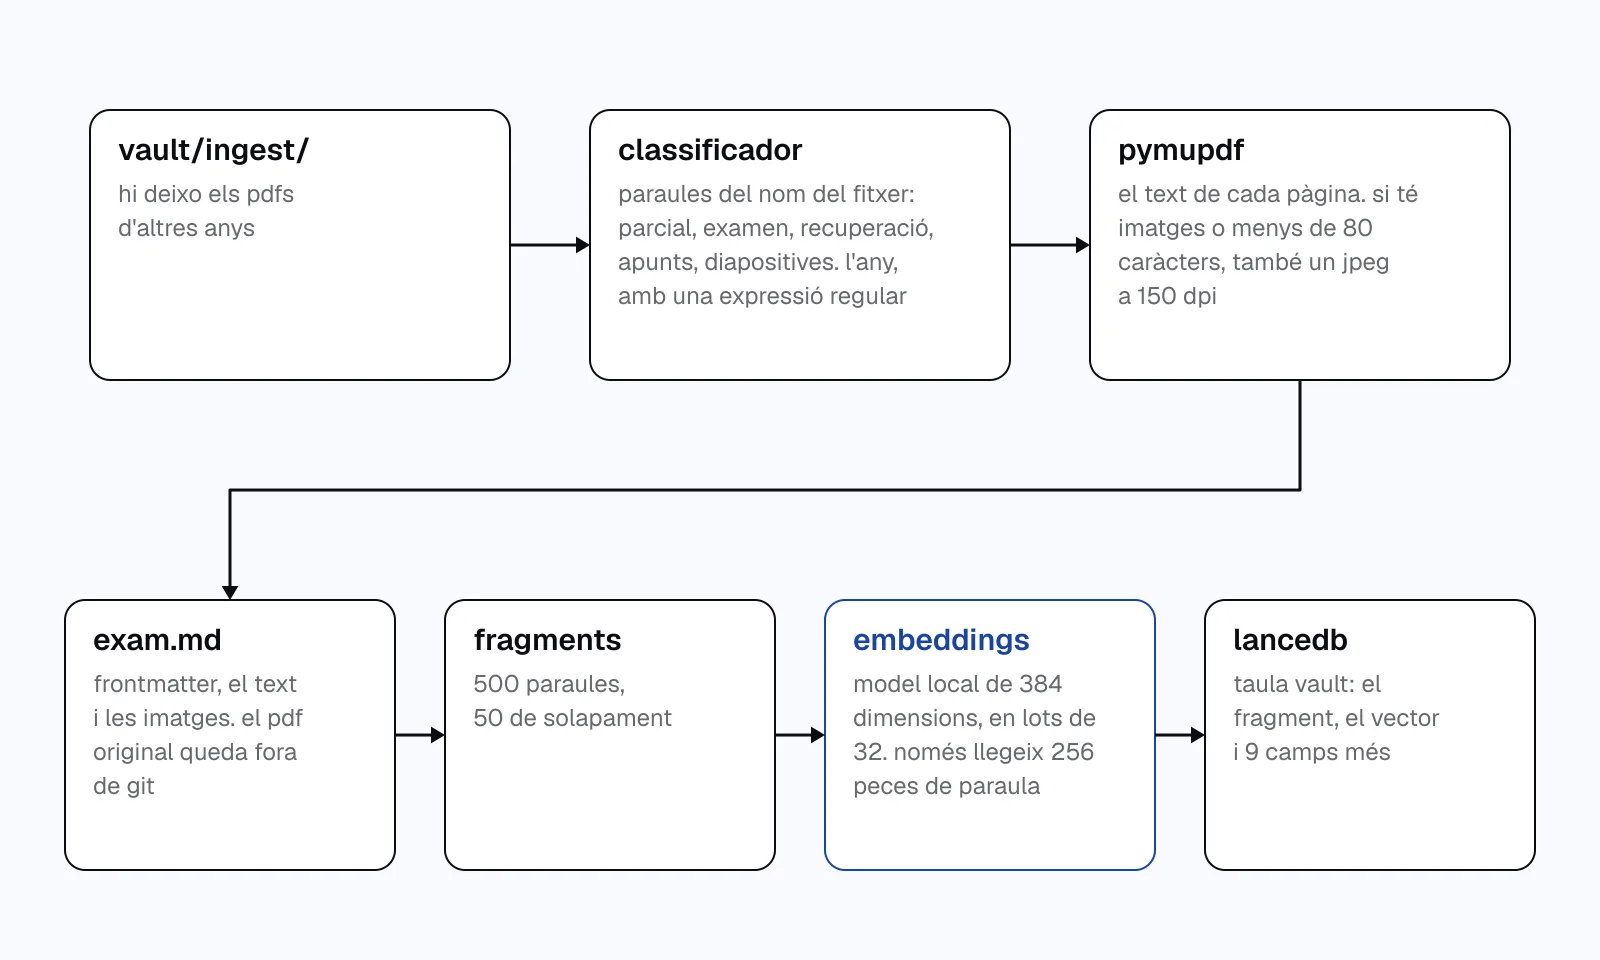
per alimentar-ho, deixo els pdfs a vault/ingest/. process_ingest_folder() els llista amb una primera classificació que surt només del nom del fitxer. busca paraules com parcial, examen, recuperació, apunts o diapositives, en català, castellà i anglès, i l'any amb una expressió regular. si el nom és clar, l'eina diu que es pot ingerir. si no, l'agent em pregunta què és abans de cridar ingest_file().
d'un examen, pymupdf en treu el text pàgina a pàgina. si una pàgina té imatges incrustades o menys de 80 caràcters de text, també la renderitza en jpeg a 150 dpi. és una regla tosca, però cobreix els dos casos que importen, un diagrama que no surt al text i un examen escanejat que no té text. claude llegeix imatges, així que aquestes pàgines li arriben com a imatge.
el resultat és un exam.md. el frontmatter diu l'assignatura, el tipus d'examen, l'any, quantes pàgines té i quines són visuals, i a sota hi ha el text de cada pàgina amb les imatges al costat. el pdf original es copia a una carpeta raw/ que git ignora.
el primer dia hi van entrar 83 pdfs d'exàmens de quatre assignatures, 13 d'ells escanejats.
la cerca semàntica amb lancedb
la base de dades vectorial és lancedb, que no té servidor. lancedb.connect() rep una carpeta, i la base de dades viu dins el procés del servidor mcp. hi ha una sola taula, vault, amb el text de cada fragment, el vector i nou camps més: l'identificador, el fitxer d'origen, el tipus, l'assignatura, el semestre, el tema, la font, la qualitat i la data.
els fragments es tallen per paraules:
def _chunk_text(text: str, chunk_size: int = 500, overlap: int = 50) -> list[str]:
    words = text.split()
    chunks = []
    i = 0
    while i < len(words):
        chunk = " ".join(words[i:i + chunk_size])
        chunks.append(chunk)
        i += chunk_size - overlap
    return chunks or [text]
cada fragment passa per all-MiniLM-L6-v2, un model de sentence-transformers que corre a la mateixa màquina i torna vectors de 384 dimensions, sense cap api de pagament.
search_knowledge converteix la pregunta en un vector, busca els cinc fragments més propers i els filtra per assignatura i per tipus de contingut, que pot ser apunts, exàmens, normativa o campanyes. de cada resultat torna 400 caràcters i el camí del fitxer, perquè l'agent obri el document sencer si li cal.
del vps a l'ordinador en un dia
el 8 de juny, el primer dia, el servidor vivia en un vps amb coolify, amb subdomini propi i una clau d'api. abans de posar-hi res, van caldre dues correccions típiques d'un servidor mcp remot. BaseHTTPMiddleware, el middleware de starlette que feia servir per a la clau, acumula la resposta sencera abans d'enviar-la i trencava l'streaming, i el vaig canviar per un middleware asgi pur. i la comprovació de fastmcp contra el dns rebinding rebutjava les peticions fins que vaig normalitzar la capçalera Host.
a les cinc de la tarda vaig ingerir els 83 exàmens. gairebé tres hores després ho vaig moure tot a un docker a l'ordinador, obert només a localhost:8000. el mateix commit calcula els embeddings en lots de 32 per no quedar-se sense memòria, i el pla del projecte passa a dir que tot corre en una sola màquina, sense latència de xarxa ni límits de ram. l'accés des del mòbil per telegram va quedar descartat aquell mateix dia.
lancedb i els embeddings locals ja hi eren des del primer dia. al pla, lancedb hi és perquè no necessita cap procés a part, i el model perquè és local i gratuït. després del canvi, tot el sistema és un contenidor al costat del vault.
les campanyes d'estudi
una campanya és un campaign.md per examen, amb una cua d'exàmens d'anys anteriors, del més nou al més antic, i per a cadascun els exercicis fets i els que queden. update_campaign mou un exercici d'una llista a l'altra, i quan no en queda cap, dona l'examen per acabat.
el criteri de prioritat és al readme. l'objectiu per defecte és un 5 a cada assignatura. el pla del projecte ho justifica dient que el temps és de suma zero, i una hora en una assignatura que ja aproves és una hora que no poses en la que pots suspendre. s'estudia amb exàmens reals des del primer dia, i es fa una passada superficial per tot abans d'aprofundir en res.
get_dashboard ordena les campanyes actives pels dies que falten per a l'examen, hi afegeix els lliuraments dels pròxims 14 dies i proposa començar per la més urgent. log_progress, que l'agent ha de cridar després de cada resposta, deixa una entrada amb l'hora, què s'ha fet, com ha anat i els minuts des de l'anterior. quan hi torno l'endemà, get_session_log diu on ho vaig deixar.
els patrons dels exàmens, quins temes surten cada any i quins no han sortit mai, els troba claude llegint els exam.md de la cua amb aquestes eines. el codi només hi aporta una heurística al tauler, que compta els títols que es repeteixen en tres exàmens o més.
markdown, git i obsidian
tot el que el sistema sap és markdown amb frontmatter yaml. cada assignatura té un INDEX.md amb els components de la nota, cada campanya el seu campaign.md i el seu log.md, cada examen el seu exam.md. les eines del servidor, claude code i obsidian llegeixen els mateixos fitxers. obsidian hi afegeix el graf conceptual de tota la carrera, i git, l'historial, amb git_sync per fer el commit i el push des de la conversa.
el 9 de juny vaig afegir una regla a les instruccions de l'agent. primer el vault, després la memòria. quan li dono una dada nova, una data o una decisió, ha d'actualitzar el fitxer del vault abans que la seva memòria, perquè la memòria és un resum que surt del vault, i mai al revés.
el 13 de juny en vaig publicar la plantilla, sense el vault.
el que canviaria
hi ha tres coses que no aguanten una lectura atenta del codi.
la primera és la mida dels fragments. segons la fitxa del model, tot el que passa de 256 peces de paraula es talla, i cada paraula és com a mínim una peça. de cada fragment de 500 paraules, el vector en veu com a molt les 256 primeres. com que un fragment nou comença cada 450 paraules, en un document llarg almenys 194 de cada 450 paraules no entren a cap vector. a més, la fitxa diu language: en, i el classificador busca paraules com apunts o recuperació.
la segona, que search_knowledge torna a carregar el model a cada consulta. la funció que indexa ja accepta el model com a paràmetre, i la cerca no l'aprofita.
la tercera, que l'heurística del tauler compta títols, i cada exam.md té un títol per pàgina: ## Page 1, ## Page 2. amb tres exàmens d'una assignatura, "page 1" ja surt com a tema que es repeteix.
la primera és la que més importa. en uns apunts llargs, més del 40% del text no entra a cap vector, i cap cerca semàntica no el pot trobar.