spotify-downloader per dins: de spotify a mp3 via youtube
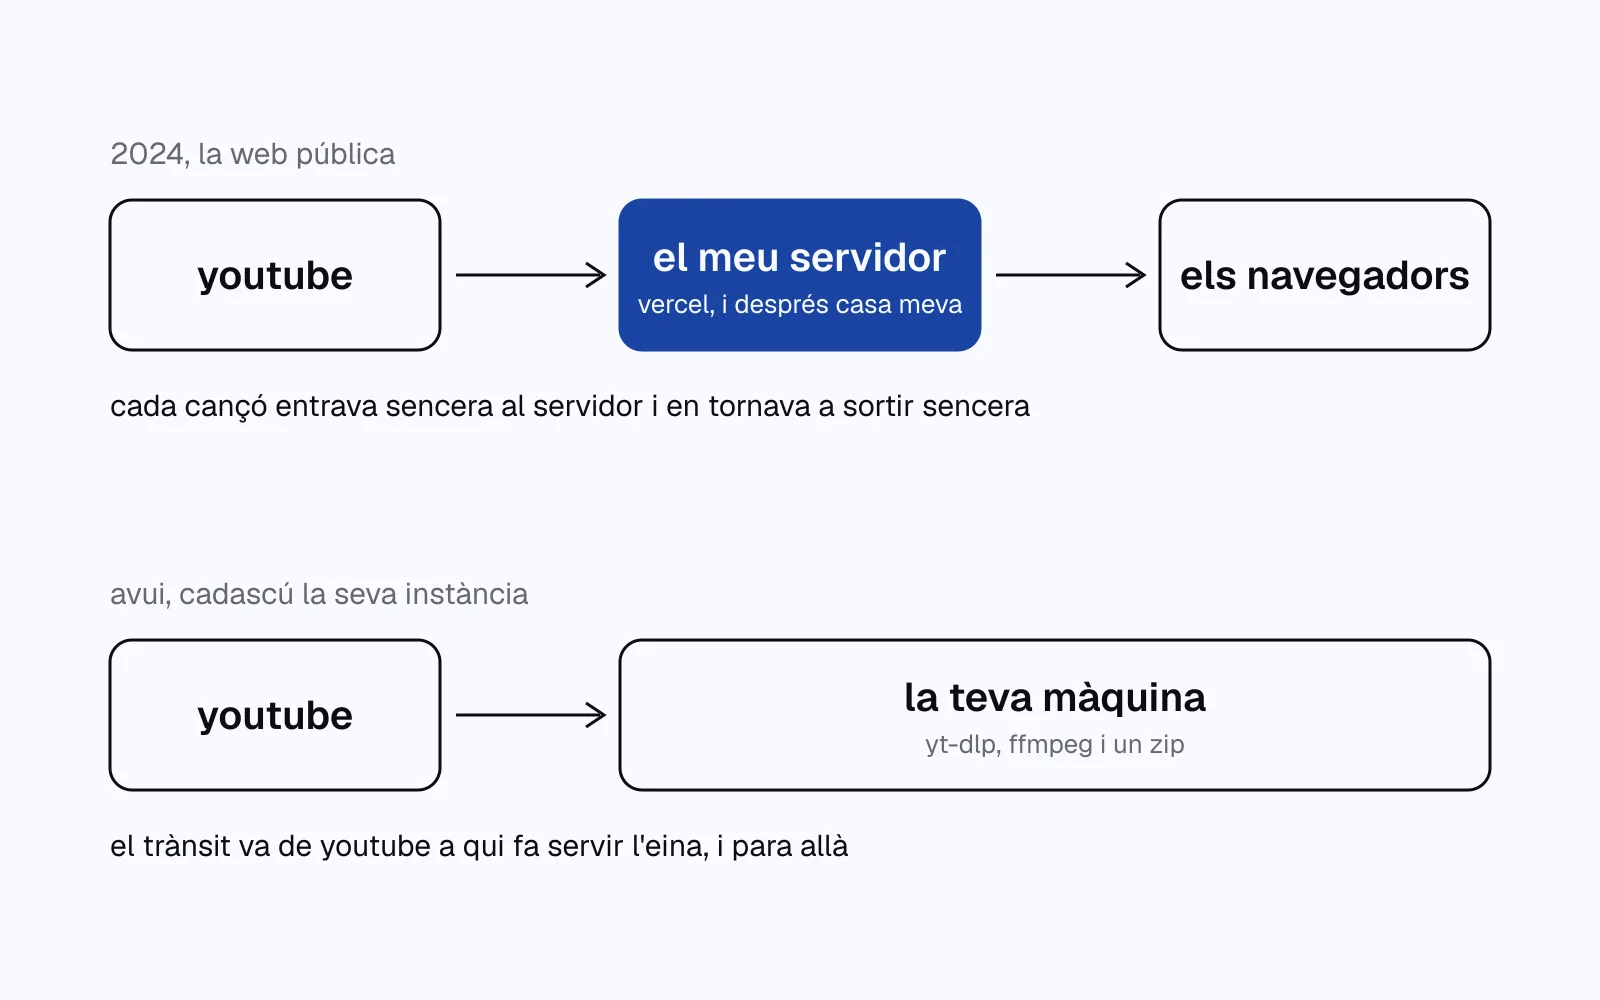
als 17 anys vaig fer una web per baixar cançons i llistes de spotify. la vaig penjar en un subreddit i en tres dies va tenir més de 400.000 visualitzacions i 2.000 usuaris actius. la capa gratuïta de vercel va servir més de 100 gb en hores. vaig passar a servir-la des de casa, en 48 hores més el trànsit va superar 1 tb, i vaig tancar el servei públic. des de llavors, qui la vulgui fer servir s'ha d'allotjar la seva pròpia instància.
trobar a youtube la cançó de spotify
spotify no dona l'àudio, només les dades. la web les demanava a l'api de spotify amb credencials d'aplicació, sense que l'usuari hagués d'iniciar sessió: títol, artistes, àlbum, portada i durada en mil·lisegons. amb això buscava la cançó a youtube.
la versió del 2024 cercava ${track.name} by ${track.artists[0].name} official, agafava els cinc primers vídeos i triava el que tenia la mateixa durada que la cançó de spotify o, si no n'hi havia cap, el més proper.
rellegint el codi, la primera comprovació no es complia gairebé mai. la llibreria de cerca calculava la durada a partir del text que ensenya youtube, "3:33", i la passava a mil·lisegons, de manera que sempre acabava en tres zeros. spotify dona mil·lisegons de veritat. només coincidien quan la cançó de spotify durava un nombre exacte de segons, així que a la pràctica la regla era "el més proper dels cinc".
el codi d'avui fa una altra cerca i accepta un marge:
query := fmt.Sprintf("ytsearch5:%s - %s lyrics", artist, title)
// ...
for _, video := range candidates {
	diff := math.Abs(video.Duration - targetSeconds)
	if diff < 1.5 {
		return video.ID, nil
	}
	if diff < shortestDiff {
		shortestDiff = diff
		bestVideoID = video.ID
	}
}
ara busca el vídeo amb la lletra en lloc de l'oficial. dels cinc resultats, en l'ordre de youtube, guanya el primer que queda a menys d'un segon i mig de la durada de spotify. si cap hi entra, guanya el més proper. un videoclip amb una intro de vint segons no passa mai el filtre, i només surt escollit si els altres quatre encara s'allunyen més.
l'mp3 que no era un mp3
el que baixava de youtube era àudio dins d'un contenidor mp4. les primeres versions li posaven l'extensió .mp3 i prou, i jo mateix ho vaig deixar escrit en una incidència del repositori, la #2. per escriure-hi el títol, l'artista i la portada calia convertir-lo de debò amb ffmpeg.
l'1 de març de 2024 la conversió la feia el servidor, amb fluent-ffmpeg. l'endemà la vaig passar al navegador amb ffmpeg.wasm, i les etiquetes les escrivia browser-id3-writer. el 6 de març vaig afegir un mode ràpid que donava l'.m4a tal com venia, sense convertir ni etiquetar, perquè convertir dins del navegador era lent.
aquella versió tenia un altre error, que es veu rellegint el codi. el número de pista es llegia de track.disk_number, un camp que l'api de spotify no té, perquè es diu disc_number. cada mp3 sortia amb el text "undefined" com a número de pista.
el codi d'avui deixa que yt-dlp extregui l'mp3 i després fa una segona passada amb ffmpeg i -c:a copy, que reescriu les etiquetes sense tornar a codificar l'àudio. abans esborra les metadades de youtube amb -map_metadata -1, de manera que tot el que porta el fitxer surt de spotify: títol, artistes, àlbum, data, número de pista sobre el total, disc, isrc, segell i copyright. la portada porta el tipus Cover (front), perquè l'explorador de windows no ensenya les que es queden amb el tipus per defecte. i la qualitat alta no promet 320 kbps, perquè l'àudio original de youtube rarament passa dels 160.
per què va caure
a la versió pública, cada cançó era una petició al servidor. la funció de vercel baixava l'àudio sencer de youtube a la memòria i el retornava com a resposta. per a una llista, el navegador en demanava deu alhora, i quan acabava un bloc en demanava deu més.
és a dir, cada byte que baixava un usuari entrava al meu servidor i en tornava a sortir. el trànsit de sortida era la suma de totes les cançons que baixava tothom. passar ffmpeg al navegador el 2 de març va treure feina de càlcul al servidor, però no li va treure ni un byte de trànsit.
a la incidència #3 vaig escriure que vercel es queixava de l'amplada de banda, amb uns 141 gb enviats als usuaris en mig dia. la solució que proposava era enviar a l'usuari el flux de dades directament en lloc de baixar-lo primer al servidor, i al final hi afegia "not even sure if you can send a stream through an api...". la vaig tancar tres hores després.
a casa no hi havia cap límit de capa gratuïta, però les matemàtiques eren les mateixes. cada cançó continuava entrant i sortint pel meu servidor, i ara el servidor era la connexió de casa. en dos dies el trànsit va passar d'1 tb.
el kill switch
vaig tancar el servei públic per dues raons. la xarxa de casa estava saturada, i, sobretot, em vaig adonar de què volia dir gestionar aquell volum de descàrregues de música amb copyright. a partir de llavors, el projecte va passar a ser una eina que cadascú s'instal·la a la seva màquina.
el canvi de model arregla el trànsit sense tocar ni una línia del cercador. si cada usuari té la seva instància, l'àudio va de youtube a la màquina de qui l'ha demanat, i el meu servidor deixa de ser al mig. segons el document de producte del repositori, la fa servir un grup petit d'amics i família.
la reescriptura en go
el 21 de setembre de 2026 vaig substituir tot el codi antic per una reescriptura que havia començat en un repositori a part el 5 de desembre de 2025. ara és un backend en go amb un frontend en next.js, darrere d'un nginx, en tres contenidors.
cada descàrrega és una feina amb un identificador. entra en una cua, el progrés arriba al navegador per websocket, i al final el servidor empaqueta un zip, també quan és una sola cançó. les feines sobreviuen a recarregar la pàgina, perquè el navegador les desa i s'hi torna a connectar.
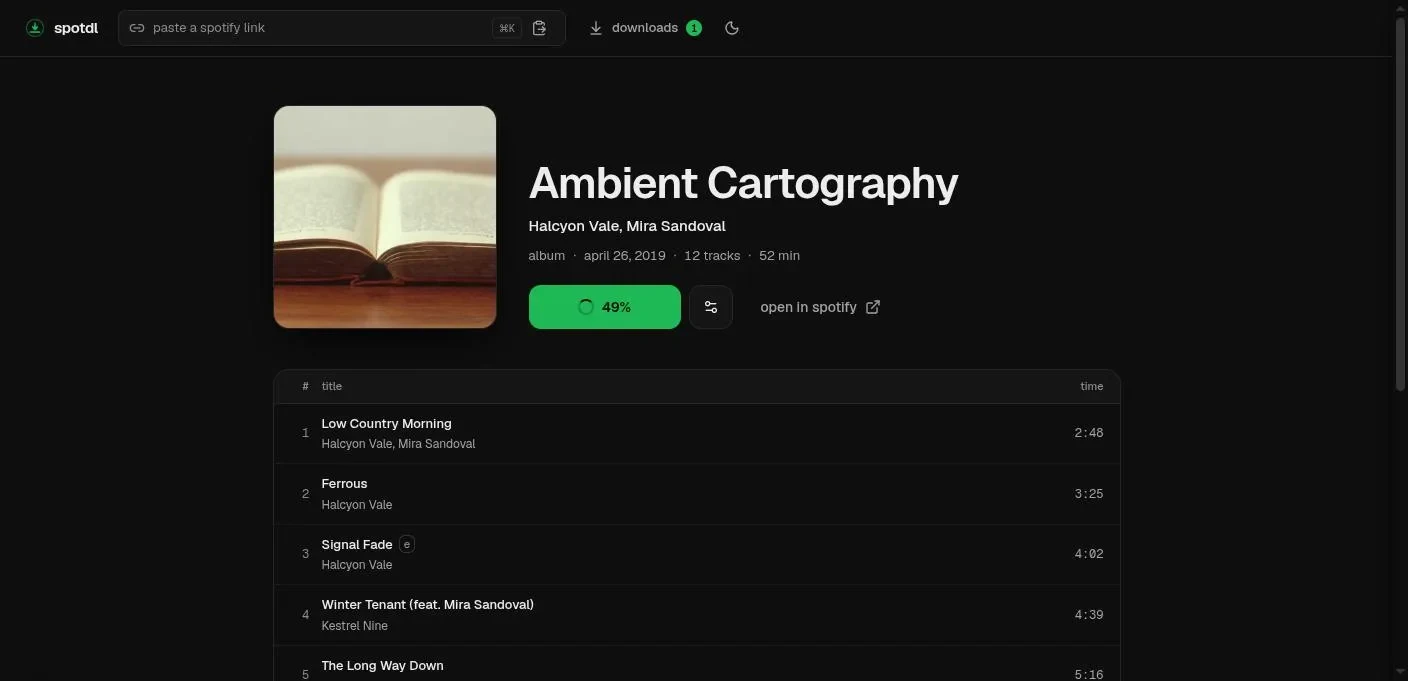
una instància necessita credencials de l'api de spotify, i segons el readme, spotify ara només deixa crear-les des d'un compte premium. la previsualització de 30 segons de cada cançó gairebé sempre surt desactivada, perquè spotify va retirar preview_url per a la majoria d'aplicacions a finals de 2024.
i hi ha un límit global. MAX_CONCURRENT_DOWNLOADS diu quantes cançons es poden estar cercant, baixant i etiquetant alhora a tot el servidor, siguin d'una feina o de cinquanta, i per defecte són 5. al codi és un canal de go amb cinc places que comparteixen totes les feines. a la versió que va moure 1 tb, cada navegador en demanava deu per llista i el servidor no tenia cap sostre.