spotify-downloader por dentro: de spotify a mp3 vía youtube
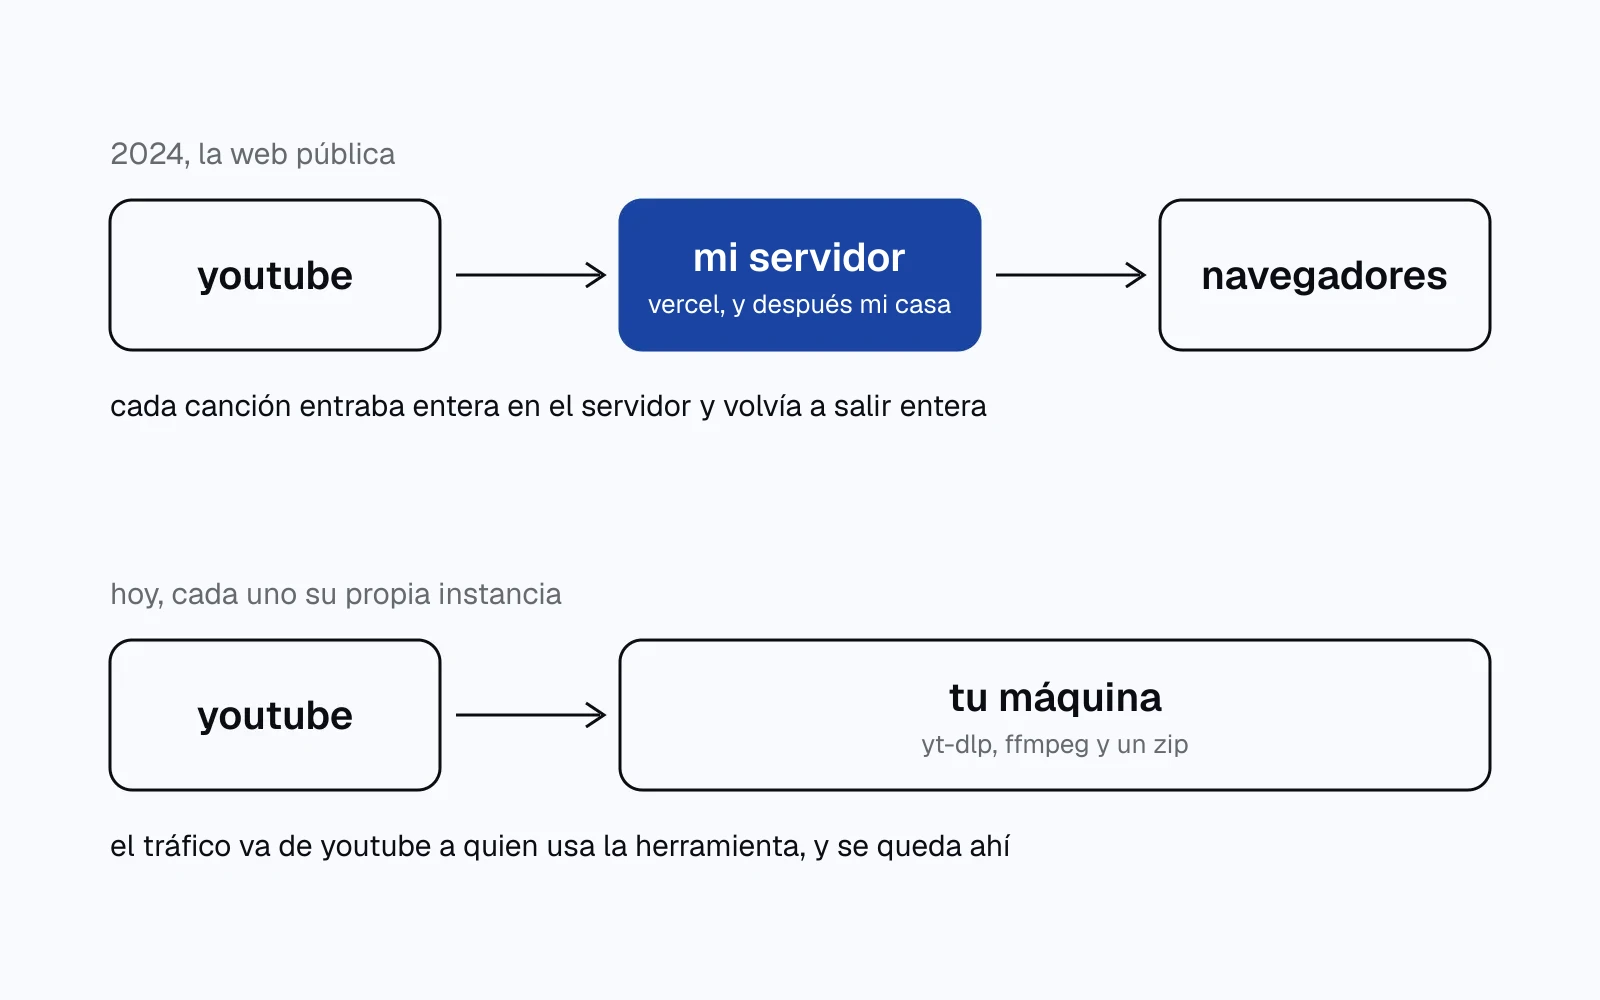
a los 17 años hice spotify-downloader, una web para descargar canciones y listas de spotify. la publiqué en un subreddit y en tres días tuvo más de 400.000 visualizaciones y 2.000 usuarios activos. la capa gratuita de vercel sirvió más de 100 gb en horas. pasé a servirla desde casa, en 48 horas más el tráfico superó 1 tb, y cerré el servicio público. desde entonces, quien la quiera usar tiene que alojar su propia instancia.
encontrar en youtube la canción de spotify
spotify no da el audio, solo los datos. la web se los pedía a la api de spotify con credenciales de aplicación, sin que el usuario tuviera que iniciar sesión: título, artistas, álbum, portada y duración en milisegundos. con eso buscaba la canción en youtube.
la versión de 2024 buscaba ${track.name} by ${track.artists[0].name} official, cogía los cinco primeros vídeos y elegía el que tenía la misma duración que la canción de spotify o, si no había ninguno, el más cercano.
releyendo el código, la primera comprobación no se cumplía casi nunca. la librería de búsqueda calculaba la duración a partir del texto que muestra youtube, "3:33", y la pasaba a milisegundos, así que siempre acababa en tres ceros. spotify da milisegundos de verdad. solo coincidían cuando la canción de spotify duraba un número exacto de segundos, así que en la práctica la regla era "el más cercano de los cinco".
el código de hoy hace otra búsqueda y acepta un margen:
query := fmt.Sprintf("ytsearch5:%s - %s lyrics", artist, title)
// ...
for _, video := range candidates {
	diff := math.Abs(video.Duration - targetSeconds)
	if diff < 1.5 {
		return video.ID, nil
	}
	if diff < shortestDiff {
		shortestDiff = diff
		bestVideoID = video.ID
	}
}
ahora busca el vídeo con la letra en lugar del oficial. de los cinco resultados, en el orden de youtube, gana el primero que queda a menos de un segundo y medio de la duración de spotify. si no entra ninguno, gana el más cercano. un videoclip con una intro de veinte segundos no pasa nunca el filtro, y solo sale elegido si los otros cuatro se alejan todavía más.
el mp3 que no era un mp3
lo que se descargaba de youtube era audio dentro de un contenedor mp4. las primeras versiones le ponían la extensión .mp3 y ya está, y yo mismo lo dejé escrito en una incidencia del repositorio, la #2. para escribirle el título, el artista y la portada había que convertirlo de verdad con ffmpeg.
el 1 de marzo de 2024 la conversión la hacía el servidor, con fluent-ffmpeg. al día siguiente la pasé al navegador con ffmpeg.wasm, y las etiquetas las escribía browser-id3-writer. el 6 de marzo añadí un modo rápido que daba el .m4a tal como venía, sin convertir ni etiquetar, porque convertir dentro del navegador era lento.
aquella versión tenía otro error, que se ve releyendo el código. el número de pista se leía de track.disk_number, un campo que la api de spotify no tiene, porque se llama disc_number. cada mp3 salía con el texto "undefined" como número de pista.
el código de hoy deja que yt-dlp extraiga el mp3 y después hace una segunda pasada con ffmpeg y -c:a copy, que reescribe las etiquetas sin volver a codificar el audio. antes borra los metadatos de youtube con -map_metadata -1, de modo que todo lo que lleva el fichero sale de spotify: título, artistas, álbum, fecha, número de pista sobre el total, disco, isrc, sello y copyright. la portada lleva el tipo Cover (front), porque el explorador de windows no muestra las que se quedan con el tipo por defecto. y la calidad alta no promete 320 kbps, porque el audio original de youtube rara vez pasa de 160.
por qué se cayó
en la versión pública, cada canción era una petición al servidor. la función de vercel descargaba el audio entero de youtube en memoria y lo devolvía como respuesta. para una lista, el navegador pedía diez a la vez, y cuando acababa un bloque pedía diez más.
es decir, cada byte que descargaba un usuario entraba en mi servidor y volvía a salir. el tráfico de salida era la suma de todas las canciones que descargaba todo el mundo. pasar ffmpeg al navegador el 2 de marzo le quitó trabajo de cálculo al servidor, pero no le quitó ni un byte de tráfico.
en la incidencia #3 escribí que vercel se quejaba del ancho de banda, con unos 141 gb enviados a los usuarios en medio día. la solución que proponía era enviar al usuario el flujo de datos directamente en lugar de descargarlo primero en el servidor, y al final añadía "not even sure if you can send a stream through an api...". la cerré tres horas después.
en casa no había ningún límite de capa gratuita, pero las cuentas eran las mismas. cada canción seguía entrando y saliendo por mi servidor, y ahora el servidor era la conexión de casa. en dos días el tráfico pasó de 1 tb.
el kill switch
cerré el servicio público por dos razones. la red de casa estaba saturada y, sobre todo, me di cuenta de lo que significaba gestionar ese volumen de descargas de música con copyright. a partir de entonces, el proyecto pasó a ser una herramienta que cada uno se instala en su máquina.
el cambio de modelo arregla el tráfico sin tocar ni una línea del buscador. si cada usuario tiene su instancia, el audio va de youtube a la máquina de quien lo ha pedido, y mi servidor deja de estar en medio. según el documento de producto del repositorio, la usa un grupo pequeño de amigos y familia.
la reescritura en go
el 21 de septiembre de 2026 sustituí todo el código antiguo por una reescritura que había empezado en un repositorio aparte el 5 de diciembre de 2025. ahora es un backend en go con un frontend en next.js, detrás de un nginx, en tres contenedores.
cada descarga es un trabajo con un identificador. entra en una cola, el progreso llega al navegador por websocket, y al final el servidor empaqueta un zip, también cuando es una sola canción. los trabajos sobreviven a una recarga de la página, porque el navegador los guarda y se vuelve a conectar a ellos.
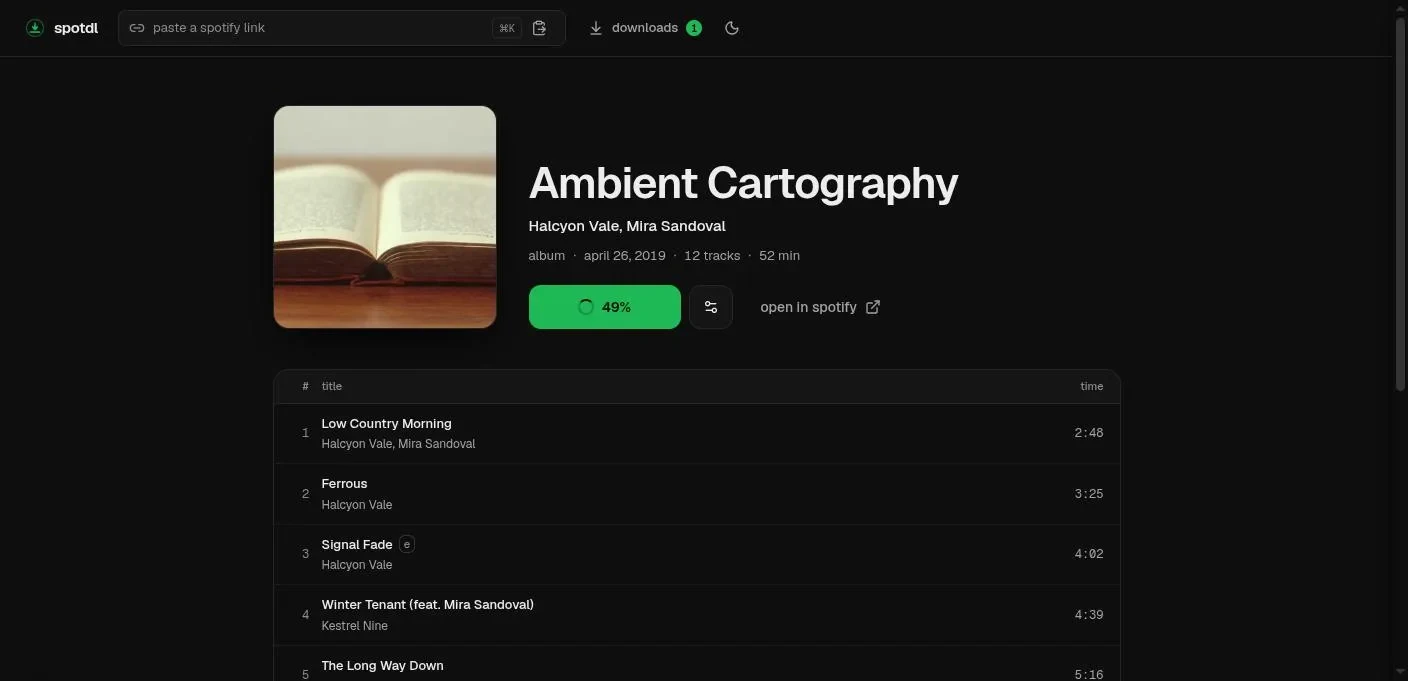
una instancia necesita credenciales de la api de spotify y, según el readme, spotify ahora solo deja crearlas desde una cuenta premium. la previsualización de 30 segundos de cada canción casi siempre sale desactivada, porque spotify retiró preview_url para la mayoría de aplicaciones a finales de 2024.
y hay un límite global. MAX_CONCURRENT_DOWNLOADS dice cuántas canciones se pueden estar buscando, descargando y etiquetando a la vez en todo el servidor, sean de un trabajo o de cincuenta, y por defecto son 5. en el código es un canal de go con cinco plazas que comparten todos los trabajos. en la versión que movió 1 tb, cada navegador pedía diez por lista y el servidor no tenía ningún techo.